
もふもふ不動産のもふです。僕は元キオクシア(旧東芝メモリ)の半導体研究開発者です。ソニー・キオクシアで16年、先端半導体の研究開発に携わり、キオクシアではNOR型フラッシュや抵抗変化型メモリ(ReRAM)の研究開発を経て、世界初の48層3次元フラッシュメモリ「BiCS FLASH™」の量産立ち上げに参画しました(2019年まで在籍)。詳しくは研究開発者としての経歴ページをご覧ください。
AIのニュースで毎日のように目にする「HBM」。2026年10月28日に発表されたSK hynixの7〜9月決算は、売上が初めて100兆ウォンを超え、営業利益率は79.7%に達しました。その追い風の1つがHBM4の本格出荷です。でも「HBMって結局なに?普通のメモリと何が違うの?」と聞かれると、説明できる人は意外と少ないんですよね。この記事では、そもそもDRAMとは何かから始めて、HBMの仕組み・作り方・世代・作れる会社・投資家にとっての意味まで、図を見ながら順番に解説します。
よくある質問
HBM(High Bandwidth Memory)とは何ですか?
DRAMのチップを縦に何段も積み重ね、GPUなど計算するチップの真横に置いたメモリです。日本語では広帯域メモリと呼び、JEDECという業界団体の規格です。チップに開けた細い穴(TSV)で上下をつなぎ、1個で1,024本(HBM4では2,048本)の線を同時に使ってデータを運ぶため、普通のDRAMより桁違いに速くデータを出し入れできます。
HBMと普通のDRAM(DDR5)の違いは何ですか?
中身は同じDRAMですが、線の本数が桁違いです。パソコンのメモリ(DDR5)は1枚で64本の線で、1秒に約51GBを運びます。HBM3Eは1個で1,024本の線を使い、1秒に約1,229GB。約24倍です。1本あたりの速さはHBMのほうが遅いのですが、本数で圧倒しています。その代わりチップを積んで同じ台にじかに載せるため作るのが難しく、同じ容量なら普通のDRAMよりずっと高価です。
なぜAIにHBMが必要なのですか?
AI(大規模言語モデル)は、言葉を1つ出すたびにモデル全体の重みをメモリから読み直すため、計算の速さよりもデータを運ぶ速さがボトルネックになる「メモリの壁」があるからです。GPUの計算能力はメモリの速さよりはるかに速く伸びてきたので、データ運びを速くしないとGPUが待ちぼうけになります。HBMはこの運ぶ速さを桁違いに上げるメモリで、NVIDIAのH100やH200などAI用GPUはすべてHBMを載せています。
HBMを作れる会社はどこですか?中国は作れますか?
NVIDIAのAI用GPUに採用されているHBMはSK hynix・サムスン電子・マイクロンの3社が供給しています。HBMは穴を開ける(TSV)・髪の毛より薄く削る・ずれなく12段積むという難しい工程を重ねるため、作れる会社が限られます。中国のCXMTはHBM3Eを小規模に生産し始めたと2026年9月に報じられており、「作れない」と断定はできませんが、最先端品を大量に安定供給できる段階ではないとみられます。
キオクシアはHBMを作っていますか?
作っていません。HBMの中身はDRAMで、キオクシアはDRAMを作っていないNANDフラッシュの会社だからです。その代わり、NANDフラッシュをHBMのように積んでGPUの隣に置くHBF(高帯域フラッシュ)を自前で開発しています。詳しくはHBFの解説記事で書いています。
HBMとは?DRAMを積み重ねてGPUの真横に置いたメモリ
まず結論から。HBM(エイチ・ビー・エム)は「High Bandwidth Memory」の略で、日本語では広帯域メモリと呼ばれます。「帯域」とは1秒間に運べるデータの量のこと。水道のホースにたとえると、ホースが太いほど一度にたくさんの水を送れますよね。HBMは、このホースを桁違いに太くしたメモリです。
中身は、パソコンにも入っているDRAMというメモリのチップです。そのDRAMのチップを何枚も縦に積み重ね、AIの計算をするGPUのすぐ横に置いたもの——これがHBMの正体です。規格は半導体の業界団体JEDECが定めていて、最初の規格は2013年に出ました。最初にHBMを載せたGPUは、2015年に出たAMDの「Radeon R9 Fury X」です。

出典: NVIDIA H100 製品ページ・NVIDIA 技術ブログ(2022-03-22)・ダミーの記述は SemiAnalysis(2023-07-05)・HotHardware(2022-09-26)・写真 极客湾Geekerwan(CC BY 3.0)
この図を見ると、HBMの置き場は6か所あるのに、使っているのは5個だけ。「空いている1つは何?」と思いますよね。NVIDIAの技術ブログによると、設計上のフル版(GH100)はHBMを6個つなげますが、製品のH100(SXM版)は5個で80GBです。残りの1か所には、SemiAnalysisの解説やHotHardwareの報道によればダミーのシリコン(中身のない板)が置かれていて、6か所の高さを揃えてパッケージを物理的に支える役目をしています。なぜ1つ使わないのかをNVIDIAは公表していませんが、6か所のうち5か所分が正常に動けば製品にできるので、歩留まり(良品の割合)を上げるための予備というのが業界の一般的な見方です(ここは推定)。実際、メモリを強化した次のH200では6か所すべてにHBM3Eを載せて141GBになっています。

出典: 断面図は自作・写真 FritzchensFritz(CC0)
パソコンのメモリは計算するチップから数cm離れたスロットに挿しますが、HBMはチップを縦に重ねて、計算するチップと同じ台にじかに載せる。いま主力のHBM3Eなら、1枚3GBのDRAMを12段積んで1個36GBです(SK hynixの12段品)。「なぜわざわざ積むのか」「なぜGPUの横でないといけないのか」——これを順番に解き明かしていきます。
そもそもDRAMとは?パソコンの「作業机」になるメモリ
HBMを理解するには、まず中身のDRAMを知っておくと話が早いです。パソコンやスマホの中には、役割の違うメモリが何種類も入っています。
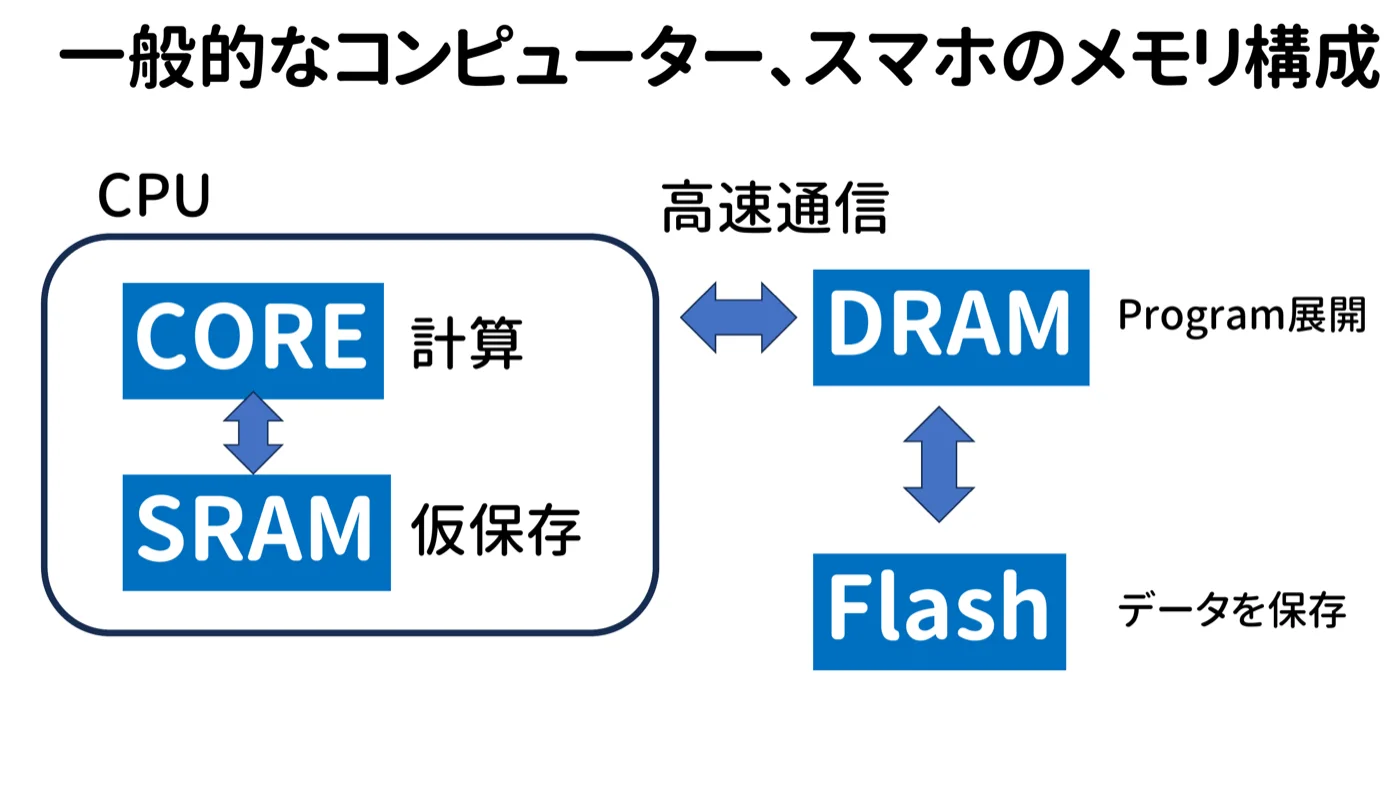
計算するチップ(CPUやGPU)を「職人」、データを「材料」にたとえると、フラッシュメモリは材料をしまっておく倉庫、DRAMはいま使う材料を広げておく作業机です。倉庫は電源を切っても中身が消えない代わりに、出し入れが遅い。作業机は出し入れが速い代わりに、電源を切ると中身が消えてしまいます(揮発性)。パソコンの性能表に「メモリ」と書いてあるのが、このDRAMです。
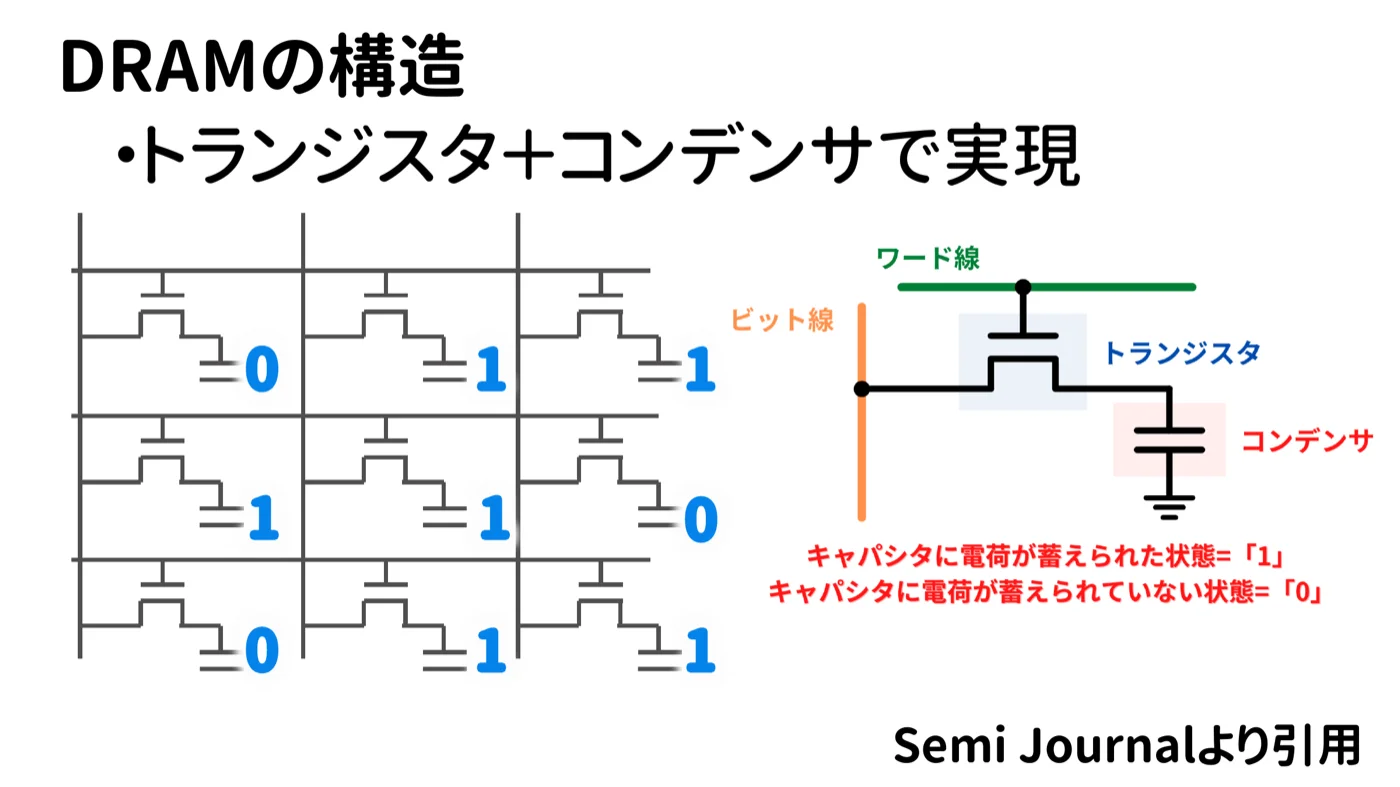
引用: Semi Journal(動画スライドより)
DRAMの記憶の最小単位(セル)は、トランジスタ1個+コンデンサ1個でできています。コンデンサは電気を溜める小さな入れ物で、電気が溜まっていれば1、空なら0。トランジスタはその入れ物の扉の役目です。これを格子状にびっしり並べて、大量のデータを覚えます。
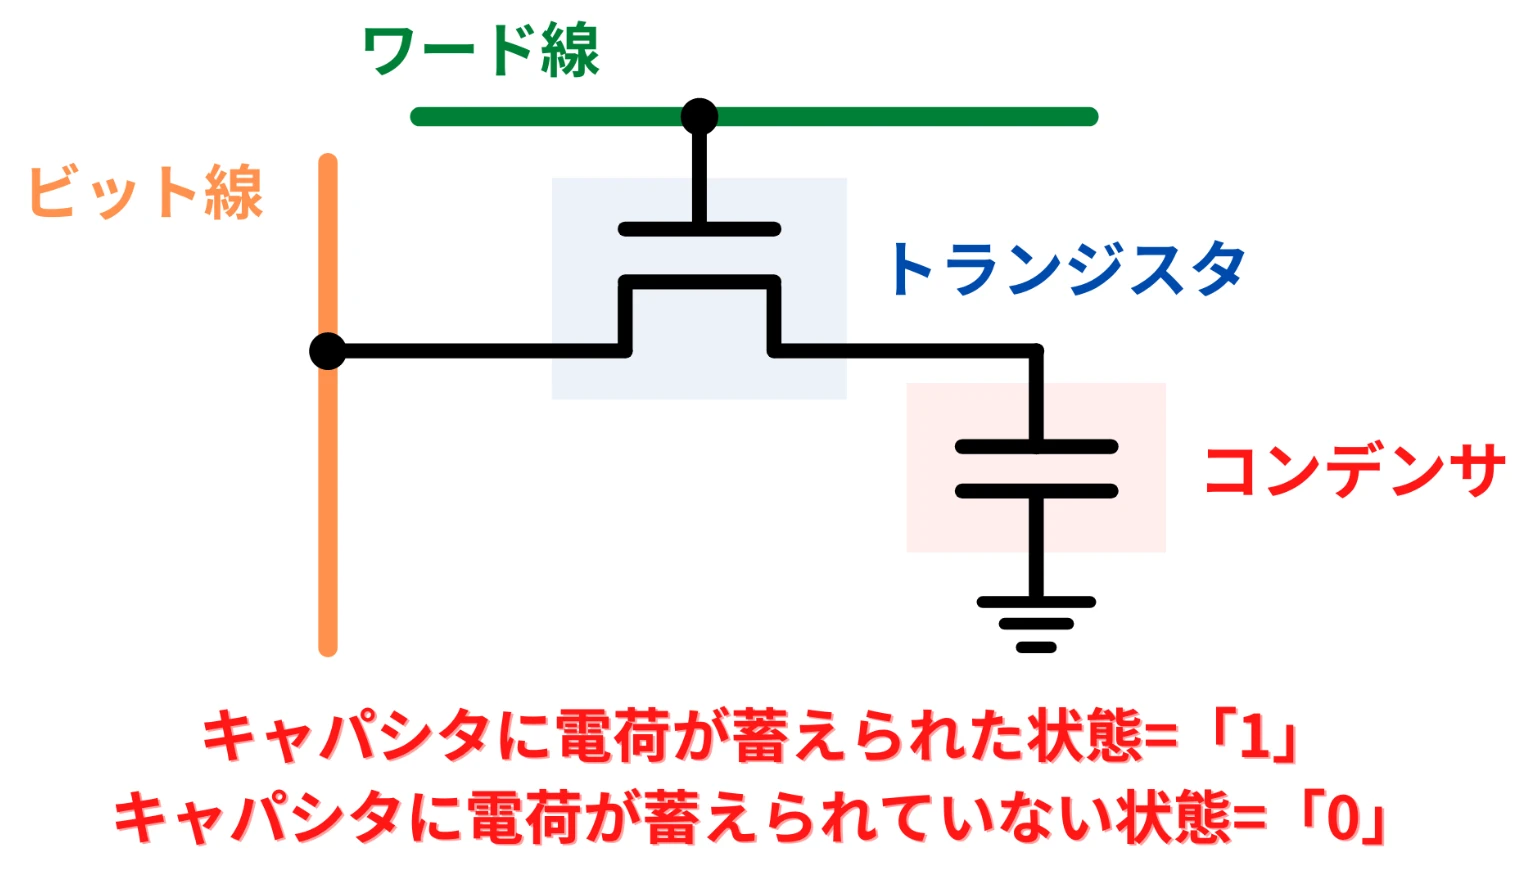
ただし、コンデンサの電気は少しずつ漏れていきます。放っておくとデータが消えてしまうので、DRAMは定期的にデータを読み出して書き戻す「リフレッシュ」を続けています。このリフレッシュは、後で出てくるHBMの「熱」の問題にも関わってくるので覚えておいてください。
DRAMにもいくつか種類があります。パソコンやサーバーに使う普通のDRAMがDDR5、ゲーム用のGPUに使うのがGDDR7、そしてAI用のGPUに使うのがHBM。3つとも中身はDRAMで、違うのは「データの出し入れの仕方」です。メモリの全体像は半導体メモリの基礎の記事、DRAMのセルの細かい構造はDRAMの4F²・6F²構造の記事で詳しく解説しています。
HBMとDRAM(DDR5)・GDDRの違い:1本は遅くても線の数が桁違い
では、HBMは普通のDRAMと何が違うのか。ポイントは「1秒に運べる量(帯域)」の稼ぎ方です。帯域は「データを送る線の数 × 線1本の速さ」で決まります(ビットをバイトに直すため、最後に8で割ります)。
まず線1本の速さを比べると、DDR5(DDR5-6400)が毎秒6.4ギガビット、HBM3Eが9.6ギガビット、ゲーム用のGDDR7は32ギガビット。1本あたりでは、HBMはゲーム用の約3分の1しかありません。ちょっと意外ですよね。

出典: JEDEC DDR5・Wikipedia(HBM・GDDR7)

出典: JEDEC DDR5・Wikipedia(HBM・GDDR7)
ところが、線の数が桁違いです。HBM3Eは1個で1,024本。ゲーム用の32倍、パソコンのメモリ1枚の16倍です。道路にたとえるなら、GDDR7は「1車線をめちゃめちゃ速く走るスポーツカー」、HBMは「そこそこの速さの車が1,024車線で並んで走る超巨大道路」です。

出典: JEDEC DDR5・Wikipedia(HBM・GDDR7)・計算
掛け算すると、1秒に運べる量はDDR5のメモリ1枚が51.2GB、GDDR7のチップ1個が128GB、HBM3E 1個は「1,024本×9.6ギガビット÷8」で約1,229GB(約1.2TB)。パソコンのメモリ1枚の約24倍、ゲーム用の約10倍です。1本の速さで負けても、本数で圧倒する。これがHBMの「広帯域」の正体です。
| DDR5(DDR5-6400) | GDDR7 | HBM3E | |
|---|---|---|---|
| 主な用途 | パソコン・サーバー | ゲーム用GPU | AI用GPU |
| 比べる単位 | メモリ1枚 | チップ1個 | 1個(1スタック) |
| 線の数 | 64本 | 32本 | 1,024本 |
| 線1本の速さ | 6.4ギガビット/秒 | 32ギガビット/秒 | 9.6ギガビット/秒 |
| 1秒に運ぶ量 | 51.2GB | 128GB | 約1,229GB |
※いずれも理論上の最大値で比べています。GDDR7の速さは製品によって異なり、規格上は最大48ギガビットとする報道もあります。
なぜAIにHBMが必要なのか:計算よりデータ運びが遅い「メモリの壁」
では、なぜAIにはこれほど太いホースが必要なのか。ChatGPTのような生成AI(大規模言語モデル)が返事を作る仕組みを見ると分かります。

出典: NVIDIA Technical Blog(2023-11-17)
生成AIは、返事を1語(トークン)ずつ順番に作っています。そして1語を作るたびに、モデルの中身——数百億個にもなる数字(パラメータ)——をメモリから全部読み出して計算します。たとえば「Llama2 70B」というモデルなら、名前の「70B」は700億個という意味です。NVIDIAの技術ブログも、この段階は計算の速さではなく、メモリから読み出す速さで決まる(メモリ律速)と説明しています。GPUの計算そのものは一瞬なのに、データが届くのを待つ時間のほうが長いんです。

出典: Gholami ほか「AI and Memory Wall」arXiv:2403.14123(2024-03-21)
しかも、この差は年々開いています。2024年に発表された論文(Gholamiほか)によると、過去20年でサーバーの計算する力は6万倍になったのに、DRAMの運ぶ力は100倍にしかなっていません。計算ばかり速くなって、メモリが追いつかない。これを「メモリの壁」と呼びます。

出典: NVIDIA H200 製品ページ(2026-10-22取得)・イラスト いらすとや
僕はよく「GPUはエンジン、データはガソリン」とたとえます。HBMは燃料のタンクとホースです。どんなに高性能なエンジンでも、ガソリンが来なければ走れませんよね。
これをよく表しているのが、NVIDIAの「H200」です。H100からH200への変更では、メモリをHBM3eにして、帯域(ホースの太さ)を毎秒3.35TBから4.8TBへ約1.4倍、容量(タンク)を80GBから141GBへ約1.8倍にしました。その結果、NVIDIAの公表値(暫定値)でLlama2 70Bの推論は1.9倍に。帯域と容量のどちらが何割効いたかは公表されていませんが、タンクが大きいと質問をまとめて処理できるので、ホースの太さと合わせて1.9倍になった——というのが僕の理解です。計算ではなく、メモリを強くして速くなったわけです。

出典: NVIDIA 製品ページ(A100・H100・H200)・NVIDIA Technical Blog(2026-07-21)・AMD 製品ページ
だからこそ、AI用GPUは世代ごとにメモリを強化しています。A100は80GB・毎秒約2TB、H100は80GB・3.35TB、H200は141GB・4.8TB、そして最新のRubinはHBM4を最大288GB・毎秒最大22TB。AMDのMI355Xも288GB・毎秒8TBです。AI用GPUの性能競争は、半分はメモリの競争と言っていいと僕は思っています。
HBMの仕組みと構造:なぜ普通のDRAMでは線を増やせないのか
「線を増やせば速くなるなら、普通のDRAMも線を増やせばいいのでは?」——ここがHBMの核心です。答えは「基板の上では、線を1,000本も並べる場所がない」からです。

出典: Hot Chips 28 SK hynix 講演資料(2016年8月)・PCBONLINE(業界の解説)
線を1本増やすには、チップの「足」(端子)も1本増やす必要があります。パソコンの基板では、チップの足ははんだの玉で、その間隔は細かいものでも約0.4mm、一般的には0.8〜1.0mmほど。一方、HBMの足(マイクロバンプ)の間隔は、HBM2世代で0.055mm(55マイクロメートル)しかありません。HBM2では1個に4,000個を超える足があります。こんな細かい足は、普通の基板ではつなげないんです。

出典: Hot Chips 28 SK hynix 講演資料・写真 FritzchensFritz(CC0)
そこで答えの1つ目が、シリコンの台(インターポーザー)です。チップと同じシリコンで作った板なので、チップと同じ細かさで配線を引けます。この台の上にGPUとHBMを並べ、台の中の細い配線で1,024本をつなぐ。GPUとHBMの距離はわずか1cmほどです。TSMCの「CoWoS(コワス)」が代表的な技術ですね。線が短いほど、データを送るのに要る電力も小さくて済みます。
その代わり、パソコンのメモリのように後から挿したり増設したりはできません。GPUとHBMを台の上で組み立てて、1つの部品として出荷します。GPUとHBMを載せる基板についてはイビデンのAI向け基板の記事もどうぞ。

出典: Hot Chips 28 SK hynix・Samsung Newsroom(2019-10-07)
ただ、シリコンの台は広げるほど高価で、作るのも難しくなります。H100でもHBMを置けるのは6か所だけ。そこで答えの2つ目が「縦に積む」です。DRAMのチップに上から下まで貫通する穴を開け、銅を詰めて縦の配線にする。これをTSV(Through-Silicon Via・シリコン貫通電極)と呼びます。
各段の同じ位置にTSVを開け、段と段の間を足でつなげば、上から下まで1本の通り道になる。ビルの各階の同じ場所に階段があるのと同じです。積めば積むほど容量が増え、場所(面積)は同じまま。いちばん下には、GPUとのやり取りを仕切る土台のチップ(ベースダイ)があります。サムスンが2019年に発表した12段品では、12枚のチップを6万個を超えるTSVでつなぎ、穴の太さは髪の毛の20分の1でした。

出典: J.-H. Cho ほか(SK hynix)「A 1.2V 64Gb 341GB/s HBM2 Stacked DRAM with Spiral Point-to-Point TSV Structure and Improved Bank Group Data Control」ISSCC 2018 発表12.3のスライド © 2018 IEEE・メンバーシップ動画「HBMの作り方」のスライドより引用
実物を見てみましょう。上の写真は、SK hynixが2018年の半導体回路の国際学会(ISSCC)で発表したHBM2の、2種類のチップの顕微鏡写真です。「Core Die」と書かれた写真のコアダイが積み重ねるDRAM本体で、格子状に区切られて見えるのがデータをためるメモリの区画(バンク)です。その真ん中を横切る帯がTSV領域(TSV AREA)。先ほどの「縦の穴」はチップ全面に散らばっているのではなく、この帯に集めて開けてあります。帯に集めれば、どの区画からも近い距離で縦の通り道に届き、上下のチップで穴の位置も合わせやすい——そう考えられます。拡大写真のBANK POWER TSVは、信号ではなく電力だけを上下に通す穴で、区画のあいだに置いて電圧を安定させる工夫です。
「Base Die」と書かれた写真のベースダイが、いちばん下の土台のチップです。こちらにはメモリの区画がなく、中央に3つの帯が並んでいます。PHY(フィジカル層)はGPUと1,024本の線で電気のやり取りをする送受信の回路、TSV領域は上に積んだコアダイへ縦につなぐ穴の集まり、DABは直接アクセス用の端子(ボール)が並ぶ場所と見られます(HBMの規格にある、積んだあとに外から直接テストするための端子。略称の正式な展開は発表スライドに書かれていません)。つまり土台のチップは、GPUと上のDRAMたちの間に立つ「窓口」。この窓口がHBM4で大きく変わる話は、あとの世代の節で出てきます。
HBMの作り方(製造工程):穴を掘り、髪の毛より薄く削り、12段に積む
ここからは、元研究開発者として一番語りたいところです。HBMは、普通のDRAMの作り方に「穴を開ける」と「薄く削って積む」という2つの難しい工程が丸ごと加わります。
工程の全体像は、SK hynixが公開している下の図が一番分かりやすいので、メンバーシップ動画で使った資料をそのまま2枚載せます。全部で12工程。前半の1〜6はウェハ(シリコンの円盤)の表側に穴と配線と足を作る工程、後半の7〜12は裏側を削って足を付け、積む工程です。図は断面図で、緑がシリコン、黄色い縦棒が穴に詰めた銅、灰色の丸が足(はんだ)です。1つずつ見ていきましょう。後工程の全体像は半導体の後工程の記事で解説しています。

出典: SK hynix Newsroom「半導体後工程 第8回 ウェハレベルパッケージ工程」(2023年5月30日)の図4「TSVパッケージ工程順序」(ⓒ한올출판사)・メンバーシップ動画「HBMの作り方」のスライドより引用
工程1 Silicon Etch(穴を掘る)。トランジスタを作る高温の工程が終わったあと、配線を作る前に、ウェハの表面から縦に深い穴を掘ります。図の緑の板に入った切れ込みがその穴で、これが先ほどのTSVの元になります。この細い穴を、ずれなく何万個も開けなければなりません。
工程2 TSV Cu Fill(銅を詰める)。穴の内側に電気を通さない膜を付けてから、銅をめっきで流し込んで穴を埋めます。図の上面がオレンジ色になっているのは、穴だけでなくウェハの表面にも銅が余分に付くからです。
工程3 TSV Cu CMP(余分な銅を磨く)。表面に付いた余分な銅を、薬品と研磨で平らに削り取ります(CMP=化学機械研磨)。穴の中の銅だけが残り、表面はまた平らになります。
工程4 BEOL Metallization(配線を作る)。その上に、普通のDRAMと同じ金属の配線層(BEOL=配線工程)を作り、足を付けるためのアルミのパッド(台座)を開けておきます。ここまでが、チップを作る工場(前工程)の仕事です。
工程5 Front Side Bump Formation(表に足を作る)。パッドの上に、小さな金属の足(マイクロバンプ)を作ります。これが上下のチップをつなぐ接点で、先ほど見たとおり間隔は0.1mmより細かい。
工程6 Wafer Solder Reflow(はんだを丸める)。足の先のはんだを加熱して溶かし、丸く整えます。前半はここまでで、ウェハはまだ元の厚さのままです。

出典: SK hynix Newsroom「半導体後工程 第8回 ウェハレベルパッケージ工程」(2023年5月30日)の図4「TSVパッケージ工程順序」(ⓒ한올출판사)・メンバーシップ動画「HBMの作り方」のスライドより引用
工程7 Temporary Carrier Bonding(支えの板に仮に貼る)。足を作った表側を下にして、支えの板(キャリアウェハ。図の紫の層)に仮に貼り付けます。このあとウェハを極端に薄くするので、支えがないと割れたり反ったりして扱えないからです。
工程8 TSV Exposure & Back Side Passivation(裏を削って保護膜)。裏側を削って薄くし、穴に詰めた銅の頭を裏から顔を出させます。穴の深さまで削るので、ウェハはこの時点で髪の毛より薄くなります。削った面には、電気を通さない保護膜(パッシベーション)をかけます。
工程9 Passivation CMP & TSV Cu Exposure(保護膜を磨いて銅を出す)。保護膜を研磨して平らにし、銅の頭だけが保護膜から出た状態にします。これで裏側からも縦の通り道につなげます。
工程10 Back Side Bump Formation(裏に足を作る)。裏側にも足を作ります。これで表と裏の両方に足があり、上にも下にもつながるチップになりました。普通のDRAMにはない、HBMならではの姿です。
工程11 Carrier Wafer Debonding & Thin Wafer Mounting on Tape(支えを剥がす)。支えの板を剥がし、薄いウェハを粘着テープに移します。このあとテープの上でチップごとに切り分けます。東京エレクトロンは、この仮貼り(工程7)と剥離(工程11)の装置がHBMの製造に使われていると公式に書いています。
工程12 Chip Stacking & PKG Assembly With Overmold(積んで固める)。土台のチップの上に、切り出したDRAMを1枚ずつ積んで足どうしをはんだで接合し、全体を樹脂で覆って固めます。図の右下が完成形で、土台の上にDRAMが重なり、いちばん下に基板へつなぐ大きなはんだの玉が並んでいます。
12工程のうち、元研究開発者として「ここが難しい」と思うのは「削る」(工程7〜11)と「積む」(工程12)です。順に見ていきます。

出典: KED Global(2023-04-20)・SK hynix Newsroom(12段HBM3E)から作図
まず「削る」。HBMは全体の高さの上限が決まっていて(HBM3E世代まで720マイクロメートル、HBM4で775マイクロメートルとされています)、段数を増やすなら1枚1枚を薄くするしかありません。12段のHBM3では、DRAM1枚が約0.03mm(30マイクロメートル)まで薄くされていると報じられています。髪の毛より薄いんです。SK hynixも、12段HBM3Eのチップは8段のHBM3より40%薄いと公表しています。
こんなに薄いウェハは、そのままでは割れたり反ったりして扱えません。だから工程7で支えの板に貼り付けてから裏を削り(工程8)、銅の頭を出して(工程9)裏側にも足を作り(工程10)、最後に支えから剥がす(工程11)。「貼って、削って、剥がす」という遠回りが要るわけです。

出典: ServeTheHome(Hot Chips 2026、2026-08-23)・SK hynix Hot Chips 28・アジア経済(2024-07-16)・TrendForce(2025-04-24・2025-12-12)を元に作図
そして「積む」。工程12で、土台のチップの上にDRAMを1枚ずつ積んでいきます。上下の足を数十マイクロメートルの間隔で、何千個も同時にぴったり合わせなければなりません。報道によれば、HBM4の土台のチップには穴(TSV)が2万個超、足が16,148個。この工程で使う装置を「TCボンダー」と呼びます。

出典: 計算(1段ごとの成功率98%を仮定し、12回・16回かけた値)
積む工程の怖いところは、1段でも失敗すると、積んだ全部が無駄になることです。仮に1段積むごとの成功率が98%だとしても、12段すべて成功する確率は約78%、16段なら約72%まで下がります(説明のための仮定の計算で、実際の数字ではありません)。だからHBMは積んだあとにも検査が必要で、アドバンテストによれば、普通のDDR5より検査に時間がかかります。

出典: SK hynixのDRAMのデータシート・米国特許を元に作図
最後の難所が熱です。HBMは、猛烈に発熱するGPUのすぐ横で、DRAMを12段も重ねています。DRAMは熱に弱く、85℃を超えると、さっきの「リフレッシュ」を2倍の頻度でやらなければなりません。その分、データを出し入れできる時間が減ってしまうわけです。
積み方には大きく2つの流派があります。チップを1枚ずつ熱と圧力で押し付け、間にフィルムをはさむTC-NCF(サムスンなど)と、全部積んでから一度に加熱して接合し、すき間に液状の樹脂を流し込むMR-MUF(SK hynixが2019年からHBMに採用)です。どちらが熱を逃がしやすいかは、資料によって評価が逆に読めるものもあり、一概には言えません。サムスンはTC-NCFを改良し、チップ間のすき間を7マイクロメートルに詰めた12段のHBM3Eを2024年に発表するなど、各社とも改良を重ねています。
さらにその先には、はんだの足を使わず銅と銅を直接くっつける「ハイブリッドボンディング」が控えています。ただ報道によれば、SK hynixはHBM4Eまでは今の足(マイクロバンプ)を使い続け、導入はHBM5へ後ろ倒しになる見通しです。ちなみにキオクシアも、3次元フラッシュの回路とメモリを別々のウェハで作り、銅で直接貼り合わせる「CBA」という技術を使っています(HBMとは別の製品で、HBMにCBAを使うという話ではありません)。穴を開ける・削る・貼る・積む・測る——HBMは、前工程以上に後工程の腕が問われる製品だと僕は考えています。
HBMの世代:HBM1からHBM4へ。HBM4で何が変わるのか
HBMは2013年の最初の規格から、世代を重ねるごとに速くなってきました。主な数字を1枚の表にまとめます。

出典: Wikipedia(HBM)・JEDEC HBM4(New Electronics 2025-04-16)・NVIDIA(2026-05-31・技術ブログ 2026-07-21)
※図の年は、規格の発表か最初にGPUへ載った年(HBM1の規格は2013年で、最初のGPUは2015年のAMD Fiji世代)。HBM3EはHBM3の高速版で、独立した規格番号を確認できず、1本の速さはSK hynixの12段量産品の値です。HBM4の行の「Rubinなど」は搭載を発表したGPUの例(NVIDIAの次世代GPU Rubin)で、どれが最初の搭載かは断定していません。出典: Wikipedia(HBM)・New Electronics(JEDEC HBM4、2025-04-16)・SK hynix Newsroom(12段HBM3E)

出典: JEDEC(2025-04-16)・Samsung(2026-02-12)・Micron(2026-03-17)・SK hynix(2025-09-12)・DDR5は計算
HBM1個が1秒に運ぶ量は、HBM1の128GBからHBM4の規格値2TBへ。約10年で16倍です。HBM4の2TBは、パソコンのメモリ1枚(DDR5-6400)の約40倍にあたります。しかも各社の製品は規格より速く、サムスンのHBM4は1本最大13ギガビット・1個最大3.3TB、マイクロンのHBM4は2.8TB超。規格は最低限のラインで、各社はその上で競っているわけです。

出典: JEDEC HBM4 規格(New Electronics 2025-04-16)
HBM4の最大の変化は、線の数を2倍の2,048本にしたことです。1本の速さで稼ぐのではなく、線の数で稼ぐ——HBMの基本方針はここでも同じ。データの通り道(チャネル)もHBM3の16から32に増え、電圧は0.7〜0.9ボルトの中から製品ごとに選べるようになりました。

出典: Samsung Semiconductor(2026-02-12)・DatacenterDynamics(2024年4月)
もう1つの大きな変化が、土台のチップ(ベースダイ)をロジックの工場で作るようになったことです。土台のチップはGPUとのやり取りを仕切る司令塔。HBM4からは、これをGPUなどを作る細かいロジックの工程で作ります。SK hynixはTSMCと組み、サムスンは自社の4ナノの工程を使っています。メモリメーカーだけでは完結しなくなったという意味で、この土台のチップが今後の勝負の分かれ目になると僕は見ています。
量産も進んでいます。サムスンは2026年2月にHBM4の商用出荷を発表し、マイクロンも2026年3月に量産出荷に入ったと報じられました。SK hynixは2026年10月の決算で、HBM4の量産・出荷が7〜9月に本格化し、10〜12月には出荷量・売上ともにHBM3Eを上回る見込みだと説明しています。次の世代のHBM4Eも、サムスンが2026年5月にサンプル出荷を始めています。
HBMを作れる会社:NVIDIAが認定した3社と、中国は作れるのか
HBMを大量に作っているのは、韓国のSK hynix・サムスン電子と、米国のマイクロンです。NVIDIAのジェンスン・フアンCEOは、この3社のHBMをいずれも認定し、生産していると述べたと報じられています。

出典: Counterpoint(Korea Herald 2026-09-03)・Reuters(2024-05-24)から作図
調査会社Counterpointによると、HBMの売上シェアは2026年1〜3月→4〜6月で、SK hynixが58%→50%、サムスンが21%→33%。マイクロンは4〜6月で18%です。先行したSK hynixを、サムスンが追い上げている構図ですね。なおSK hynix自身はIDCの数字として1〜3月のシェアを56.4%と開示していて、調査会社によって値は少しずつ違います。
サムスンは一度出遅れました。2024年5月、サムスンのHBMが発熱と消費電力の問題でNVIDIAの試験に通っていないとロイターが報じ(サムスンは否定)、その頃のNVIDIA向けはSK hynixのほぼ独占でした。そこから巻き返し、HBM4の歩留まりも量産初期の60%未満から約80%まで上がったと報じられています。2026年7〜9月のHBM売上ではサムスンがSK hynixを上回った可能性がある、という推定も出てきました(Bernsteinが輸出統計から推定したもので、実績ではありません)。メモリ各社の業績の流れはマイクロン決算の記事もどうぞ。
中国はHBMを作れるのか
では中国はどうか。結論から言うと、「作れない」とは言い切れません。2026年9月、中国のDRAMメーカーCXMT(長鑫存儲)がHBM3Eの小規模生産を始めたと米The Informationが報じ、韓国メディアなどが伝えました。アリババ傘下のT-HeadとCambriconが自社のプロセッサでテストしていて、早ければ2027年に製品に使う可能性があるそうです。
ただし、CXMTも関係各社も公式には認めておらず、生産量や歩留まりも非公表です。The Informationは歩留まりの低さが続いていて、先頭のメーカーから3〜5年遅れていると推定。分析会社SemiAnalysisの推定では、CXMTの8段HBM3の歩留まりは全体で約25%です。Counterpointも「量産規模では未実証」と評価しています。米国は2024年12月、先端HBMを中国向けの輸出規制の対象に加えました。
CXMTは普通のDRAMでは、2026年4〜6月の売上シェア7%で世界4位(Counterpointの推定)まで来ています。それでも、ここまで見てきたように、HBMは穴を開け、髪の毛より薄く削り、何千個もの足を合わせて12段積むという、後工程の積み重ねがものを言う製品です。中国は作り始めてはいるが、NVIDIAが認定した3社に量と品質で並ぶのはまだ先というのが僕の見方です。CXMTについてはCXMTの記事で詳しく書いています。
投資家にとってHBMが意味すること
ここからは投資家目線の話です。僕の個人的見解を含みます。

出典: Micron 2025年度Q2 決算説明会(2025-03-20)・Tom's Hardware(2026-08-25)から作図
まず押さえておきたいのが、HBMは普通のDRAMの約3倍のシリコンを食うということ。マイクロンのCEOは2025年3月の決算説明会で、同じビット数を作るのにHBM3EはDDR5の3倍のシリコンを使い、HBM4Eでは4倍を超える見通しだと説明しています。マイクロンの技術者によれば、HBM4のチップは区画(バンク)が256個と、DDR5の32個よりずっと多い。それらを同時に動かすための配線・電源・TSVに面積を取られるからです。シリコンを3倍使うぶん、同じ容量でも普通のDRAMよりずっと高価になります。

出典: TrendForce(2025-10-02)・NVIDIA Newsroom(2026-05-31)・NVIDIA Technical Blog
すると何が起きるか。メモリメーカーがHBMをたくさん作るほど、普通のDRAMに回すウェハが減ります。TrendForceの報道では、SK hynixのDRAMウェハのうちHBM向けは2025年の約30%から2027年には約40%に増える見込み。その結果、パソコンやスマホ向けの普通のメモリまで足りなくなり、価格が上がる。実際、SK hynixのDRAMの平均販売価格は2026年7〜9月に前期比20%台後半上がったと報じられ、同社は「メモリの需給の逼迫は2030年まで続く」と見ています。
この追い風で、メモリメーカーの業績は過去にない水準です。冒頭で触れたSK hynixの2026年7〜9月は営業利益83.33兆ウォン、サムスン電子の同じ期間の連結営業利益は107.4兆ウォン(速報値)。SK hynixは主要顧客14社と長期契約を結び、2027・2028年の生産能力の50%超をカバーしたと報じられています。
もう1つの視点は、恩恵はメモリ3社だけにとどまらないことです。HBMは工程が増えるほど、装置と材料の出番が増えます。仮貼り・剥離装置の東京エレクトロン、HBMの量産テストに使う装置を持つアドバンテスト、チップの間に挟むフィルム(NCF)をHBM向けに作るレゾナック、そして積層に使うTCボンダー(ASMPT・ハンミ半導体・ハンファ・SEMES・東レ・新川などが納めていると報じられています)。日本企業も、HBMのサプライチェーンのあちこちに顔を出しています。とはいえ、メモリは昔から好不況の波が大きい業界です。今の好況がどこまで続くかは、AI向けの需要と各社の増産のバランス次第だと見ています。
HBMの今後:容量の壁とHBF
最後に、HBMの今後です。僕の見方では、HBMの重要性が下がることはありません。AIの速さはGPUとHBMの間のやり取りで決まる、という構図は変わらないからです。
ただし、壁も見えています。それが容量です。最新のRubinでもHBM4は最大288GB(36GBのHBMを8個と計算できます)。GPUの周りにはもうHBMを置く場所がほとんどなく、12段・16段と積むのも、ここまで見てきたように難しさが増す一方です。HBMだけで容量を増やすのは、直近では難しいと僕は考えています。
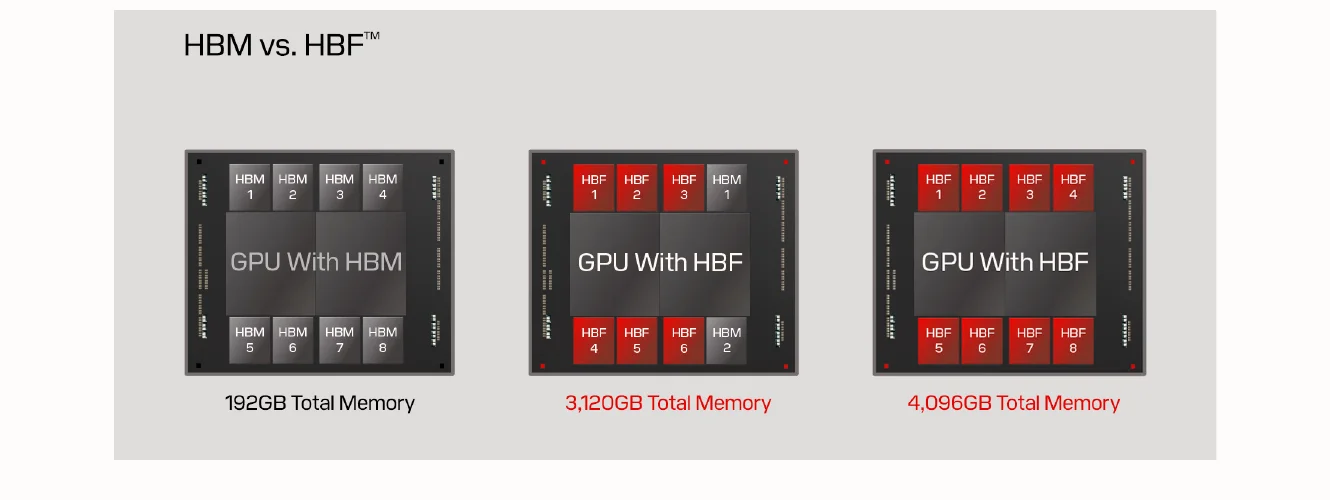
引用: サンディスク HBF Fact Sheet(PDF)
そこで出てきたのがHBF(High Bandwidth Flash)です。HBMと同じやり方で、今度はNANDフラッシュをTSVで16段積み、1個最大512GB、毎秒約0.4〜3.0TBを狙う新しいメモリで、SK hynixとサンディスクが2026年8月3日に最初の標準仕様を公開しました。HBM4と大きさを揃えてあるので、GPUの横の「HBMの席」に座れます。
HBMを全部置き換えるのではなく、速さのHBMと容量のHBFを混ぜて載せるのが想定される使い方です。上の図のとおり、HBMだけなら192GBのところ、混載なら3,120GB、全部HBFなら4,096GB。ほかにもIntelは、HBMを使わずLPDDR5Xというメモリを最大480GB載せた推論用GPUを2026年10月に公表しました。メモリを「速さ」と「容量」で使い分ける流れは、これから広がると思います。フラッシュメモリ出身の僕としてはめちゃめちゃ面白い流れで、詳しくはHBFの解説記事で書いています。
ちなみに「キオクシアはHBMを作らないの?」とよく聞かれます。HBMの中身はDRAMで、キオクシアはDRAMを作っていないNANDフラッシュの会社なので、キオクシアがHBMを作ることはありません。その代わり、NANDを積むHBFは自前で開発中です(詳しくは上のHBFの記事で)。
まとめ
僕の研究開発者としての経歴は経歴ページをご覧ください。